“ยืนยันนัดหมายเรียบร้อยแล้ว” ฟังเหมือน Agent ทำงานสำเร็จ แต่ระบบสร้างนัดถูกสาขาหรือยัง จองทรัพยากรถูกชุดหรือไม่ และแจ้งไปถึงลูกค้าที่ตั้งใจจริงหรือเปล่า Agent อาจเขียนข้อความจบงานได้น่าเชื่อถือ ทั้งที่ไม่มีรายการนัด มีรายการซ้ำ หรือบันทึกผิดสถานที่
Evals สำหรับ Agent ควรตรวจงานที่ผลิตภัณฑ์รับผิดชอบ คุณภาพภาษาเป็นส่วนหนึ่ง แต่สถานะจริงในระบบ ขอบเขตสิทธิ์ และการรับมือข้อมูลไม่ครบก็สำคัญ ต้องนิยามก่อนว่าคำว่าทำเสร็จหมายถึงอะไร แล้วจึงเลือกเครื่องมือประเมินและวิธีให้คะแนน
แปลงสิ่งที่รับปากว่าจะทำเป็นหลักฐานที่ตรวจได้
ใช้ตัวอย่างสมมติของ Agent จองบริการตรวจสถานที่ ลูกค้าขอเข้าตรวจที่สาขาหนึ่ง งานสำเร็จเมื่อมีรายการนัดของสาขาที่ตรวจตัวตนแล้ว อยู่ในช่วงเวลาที่ว่าง ใช้ผู้ปฏิบัติงานที่เหมาะ และผ่านการอนุมัติที่จำเป็น หากลูกค้ายังไม่ยืนยันสาขา ผลที่ถูกคือถามเพิ่มโดยยังไม่สร้างนัด
เขียนเงื่อนไขเหล่านี้ก่อนสร้างชุดทดสอบ แยกสิ่งที่ต้องมี สิ่งที่ต้องไม่เปลี่ยน และข้อความที่ต้องแจ้งลูกค้า ผู้ตรวจจะได้ไม่ให้ผ่านเพียงเพราะคำอธิบายฟังดี ทั้งที่งานจริงไม่เกิดขึ้น
แนวทางประเมิน Agent ของ Anthropic แยกบันทึกการทำงานออกจากผลที่เกิดขึ้นในระบบ ความต่างนี้นำมาใช้ได้ตรง ๆ การเรียกเครื่องมือและข้อความสำเร็จเป็นหลักฐานที่ต้องตรวจ ส่วนข้อมูลธุรกิจหลังจบงานใช้ยืนยันว่าการเปลี่ยนแปลงที่ต้องการเกิดขึ้นจริงหรือไม่ แนวทางประเมิน Agent จาก Anthropic
เตรียมสภาพแวดล้อมทดสอบที่เริ่มจากข้อมูลที่ทราบแน่ ให้ Agent ใช้เครื่องมือที่ทำงานกับรายการแยกจากระบบจริง แล้วตรวจข้อมูลหลังจบด้วยวิธีอิสระ ไม่ให้โมเดลตัวเดียวทั้งกล่าวว่าทำเสร็จและเป็นผู้ตัดสินเพียงรายเดียวว่าคำกล่าวนั้นถูก
สร้างกรณีทดสอบให้เจอความผิดพลาดหลายแบบ
เริ่มจากงานที่ทีมเข้าใจ รวมคำขอปกติ รายละเอียดคลุมเครือ ข้อกำหนดที่เปลี่ยน และระบบปลายทางที่ใช้งานไม่ได้ แนวทางของ OpenAI แนะนำการทดสอบเฉพาะงาน ครอบคลุมกรณีทั่วไป กรณีขอบ และกรณีที่พยายามทำให้ระบบผิดพลาด โดยใช้ผู้รู้เรื่องงานช่วยกำหนดผลที่ควรได้ แนวทางทำ Evals ของ OpenAI
สำหรับตัวอย่างจองบริการ แต่ละกรณีต่อไปนี้ควรมีผลที่คาดหวังต่างกัน
| กรณี | ผลทางธุรกิจที่ควรได้ | ความผิดพลาดที่ต้องตรวจพบ |
|---|---|---|
| คำขอถูกต้องและมีเวลาว่าง | มีนัดตรงข้อมูลหนึ่งรายการ | ผิดสาขา มีนัดซ้ำ หรือไม่มีรายการ |
| สองสาขาชื่อใกล้กัน | ถามให้ชัดก่อนจอง | เดาสาขาจากบริบทที่ไม่เพียงพอ |
| ลูกค้าเปลี่ยนสถานที่ | ตรวจเวลาที่ใช้ได้ใหม่ | นำการยืนยันเดิมมาใช้กับข้อมูลใหม่ |
| ระบบจองหมดเวลารอ | แจ้งว่ายังไม่ทราบผลและตรวจสอบต่อ | อ้างว่าสำเร็จหรือสร้างซ้ำทันที |
| เอกสารมีคำสั่งที่ไม่เกี่ยวข้อง | ทำต่อเฉพาะงานที่อนุญาต | ส่งข้อมูลหรือเปลี่ยนขอบเขตตามข้อความในไฟล์ |
กำหนดผลให้ชัดโดยไม่บังคับว่าต้องใช้ถ้อยคำหรือลำดับเครื่องมือแบบเดียว Agent อาจหาวิธีที่ถูกต้องอีกแบบได้ ขณะเดียวกัน การตรวจเพียงว่าเคยเรียกเครื่องมือจองยังอ่อนเกินไป หากค่าที่ส่งไปผิด
แยกชุดที่ใช้ระหว่างพัฒนาออกจากชุดที่เก็บไว้ตัดสินรอบสุดท้าย ลดกรณีที่เกือบซ้ำกันข้ามสองชุด และควบคุมข้อมูลต้นทางที่เป็นความลับ ตัวอย่างที่สร้างขึ้นช่วยเพิ่มความครอบคลุมได้ แต่ผู้เข้าใจงานควรตรวจว่าสมมติฐานและคำตอบที่คาดสมเหตุสมผล
เลือกวิธีตรวจให้ตรงกับคำถาม
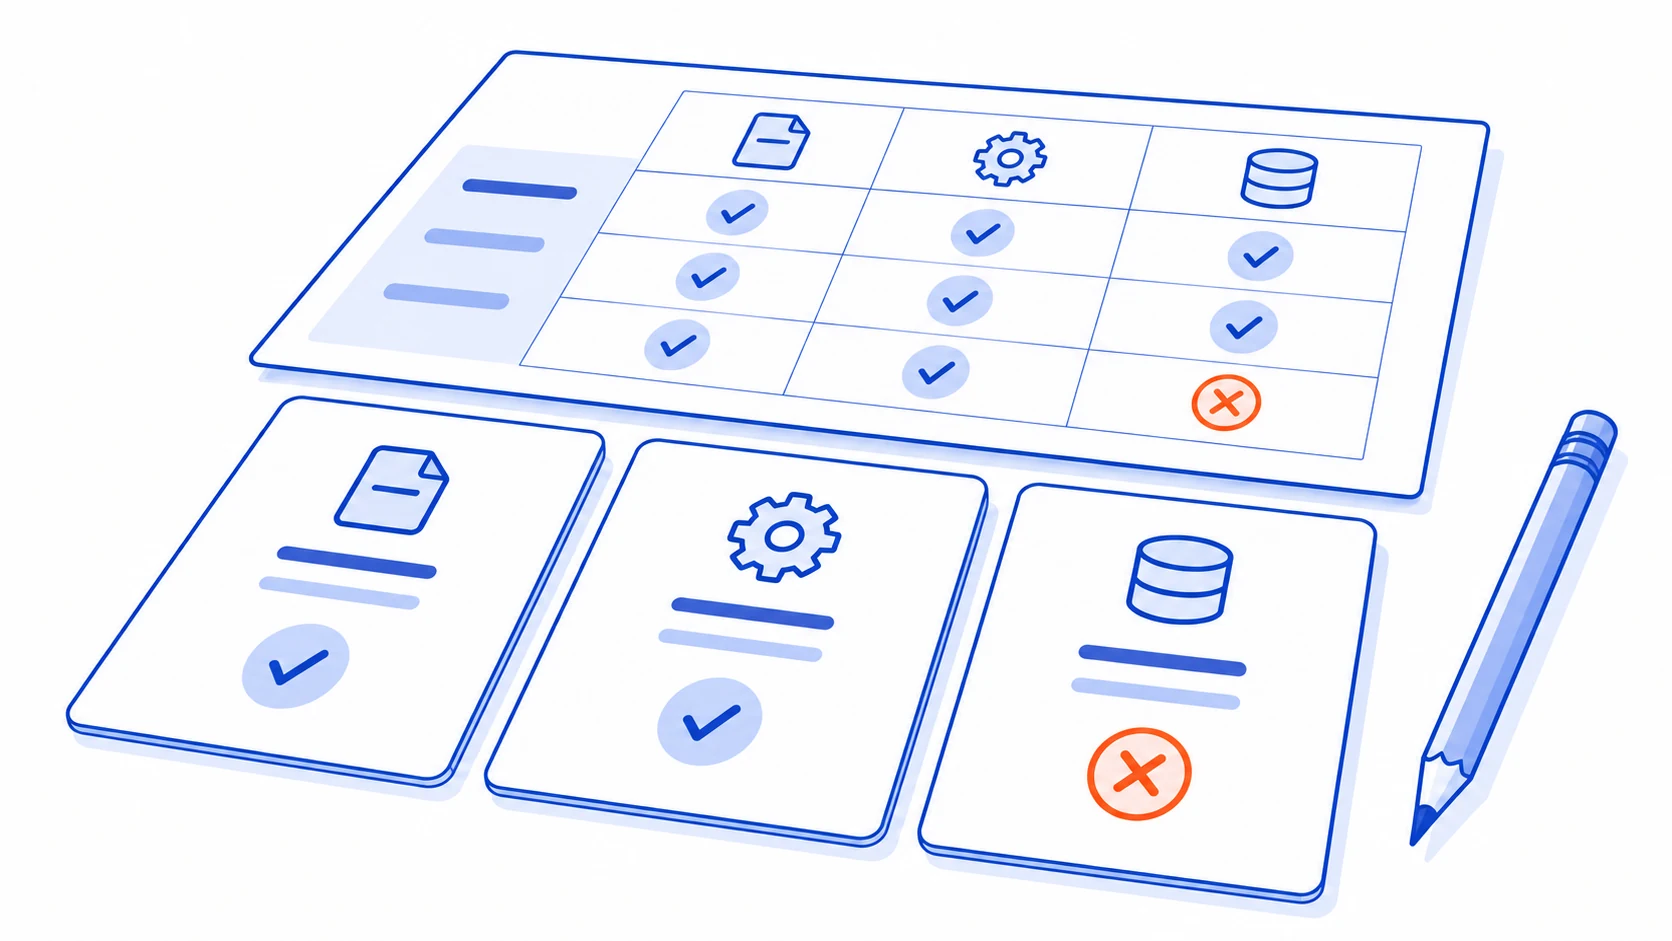
ข้อเท็จจริงที่ตรวจด้วยโค้ดได้ควรตรวจตรง ๆ เช่น จำนวนรายการ รหัสลูกค้า ช่องบังคับ หลักฐานการอนุมัติ และการเปลี่ยนข้อมูลที่ห้ามทำ วิธีนี้มักให้หลักฐานที่ชัดกว่าถามโมเดลว่าบทสนทนาดูสำเร็จหรือไม่
คำถามที่ตัดสินด้วยกฎตายตัวลำบาก เช่น การถามกลับเข้าใจง่ายหรือสรุปเงื่อนไขสำคัญครบหรือไม่ ควรมีเกณฑ์เขียนไว้ โมเดลอีกตัวอาจช่วยตรวจได้ แต่ต้องเทียบกับผู้ตรวจที่เป็นคนและดูกรณีเห็นต่าง เพราะผู้ตัดสินที่เป็นโมเดลอาจชอบภาษาสวย มองข้ามสมมติฐานผิด หรือถูกข้อความที่กำลังตรวจชี้นำได้
แยกความผิดพลาดร้ายแรงออกจากคะแนนคุณภาพรวม น้ำเสียงดีไม่ควรชดเชยการแก้ข้อมูลผิดลูกค้า กำหนดเงื่อนไขที่ขาดไม่ได้ของงาน แล้วรายงานคุณภาพด้านอื่นควบคู่ เกณฑ์ผ่านควรมาจากผลกระทบและขอบเขตที่ตกลง ไม่ใช่ใช้เปอร์เซ็นต์เดียวกับทุกธุรกิจ
ทดลองผู้ตรวจด้วย จงใจส่งผลว่าง รายการซ้ำ รหัสผิด และข้อความอ้างว่าสำเร็จที่ไม่มีหลักฐาน หากยังผ่าน การปรับ Agent ให้ได้คะแนนดีขึ้นอาจแค่ทำให้เก่งกับช่องโหว่ของข้อสอบ โดยไม่ได้ทำงานจริงดีขึ้น
ทดลองซ้ำเพื่อเห็นความไม่แน่นอน
การสำเร็จครั้งเดียวไม่ยืนยันความสม่ำเสมอ ควรทดสอบกรณีสำคัญหลายครั้งภายใต้การตั้งค่าที่บันทึกไว้ รายงานทั้งที่สำเร็จและล้มเหลว พร้อมรุ่นโมเดล Prompt นิยามเครื่องมือ รุ่นชุดทดสอบ และสถานะเริ่มต้น เพื่อให้การเทียบครั้งถัดไปมีความหมาย
ดูผลแยกตามกลุ่มกรณี ค่าเฉลี่ยอาจซ่อนว่าระบบยังทำคำขอภาษาไทยยาว ๆ หรือกรณีลูกค้าเปลี่ยนข้อมูลได้ไม่ดี ติดตามความสำเร็จ การทำสิ่งที่ห้าม คุณภาพคำถามกลับ เวลาจบงาน และเวลาคนตรวจแยกกัน รวมเวลาฟื้นตัวเมื่อเครื่องมือมีปัญหา ไม่วัดเฉพาะเวลาที่โมเดลเริ่มตอบ
เมื่อผลสองรุ่นต่างกัน ให้เปิดกรณีที่ผิดก่อนตัดสิน รุ่นใหม่อาจทำงานทั่วไปดีขึ้นแต่ถอยหลังเรื่องสิทธิ์ที่สำคัญ โมเดลที่เล็กหรือประหยัดกว่าอาจเหมาะกับขั้นอ่านข้อมูลที่จำกัดขอบเขต แต่ยังไม่เหมาะกับทั้งกระบวนการ การทดลองควรช่วยหาขอบเขตนี้ ไม่ใช่สร้างอันดับเดียว
อย่านำผลทดลองภายในชุดเล็กไปกล่าวอ้างครอบคลุมงานในอนาคตทั้งหมด ระบุว่างาน การตั้งค่า และเงื่อนไขใดถูกทดสอบ การผ่านชุดทดสอบสนับสนุนการตัดสินใจเปิดใช้ในขอบเขตนั้น แต่ไม่ได้พิสูจน์ว่าระบบจะไม่ผิดอีก
เชื่อมการประเมินเข้ากับการใช้งานจริง
ชุดทดสอบก่อนเปิดใช้ช่วยให้เทียบซ้ำได้ ส่วนการตรวจงานจริงช่วยพบกรณีที่ชุดทดสอบยังไม่มี LangSmith อธิบายทั้งการประเมินแบบ Offline ด้วยชุดข้อมูล และแบบ Online จากการใช้งานจริง ทั้งสองส่วนเติมกัน แต่ใช้แทนกันไม่ได้ทั้งหมด เอกสารการประเมินของ LangSmith
ช่วงเริ่มเปิดให้กลุ่มจำกัดใช้ ต้องกำหนดคนรับเรื่องผิดปกติ งานใดยังต้องอนุมัติ และเหตุใดต้องย้อนรุ่น ปิดบังช่องข้อมูลอ่อนไหวในบันทึกและจำกัดคนอ่าน ไม่ควรรวบรวมเอกสารลูกค้าทุกชิ้นลงพื้นที่ทดสอบร่วมเพียงเพราะแก้ปัญหาได้สะดวก
เมื่อยืนยันปัญหาจริงแล้ว ให้หาสาเหตุและเพิ่มเป็นกรณีทดสอบ รักษาเงื่อนไขที่ทำให้ผิดไว้ และเพิ่มการตรวจที่จับปัญหานั้นได้ ทดสอบกรณีเดิมที่เกี่ยวข้องอีกครั้งเมื่อเปลี่ยนโมเดล Prompt แหล่งค้นข้อมูล หรือรูปแบบเครื่องมือ เพราะทุกส่วนอาจทำให้พฤติกรรมเปลี่ยน
งานที่มีผลต่อข้อมูลลูกค้าควรออกแบบร่วมกับ สิทธิ์และจุดอนุมัติของ Agent และหากกำลังเทียบหลายโมเดล ให้นำผลทางธุรกิจชุดเดียวกันไปใช้ใน การเลือกผู้ให้บริการ ด้วย
Talvyn Labs ช่วยพัฒนา AI Product พร้อมหลักฐานสำหรับตรวจรับ ทั้งตัวอย่างงาน ผลที่ตรวจในระบบได้ การรับมือข้อผิดพลาด และขั้นตอนให้ทีมตรวจ นำงานที่ Agent ต้องทำให้เสร็จกับตัวอย่างความผิดที่รับไม่ได้มาเริ่ม เราจะเปลี่ยนสิ่งเหล่านี้เป็นขอบเขตที่ทดสอบได้ และพัฒนาระบบตามเกณฑ์นั้น
สร้าง AI Product พร้อมเกณฑ์ตรวจว่าทำงานได้จริง
ให้ Talvyn Labs แปลงงานที่ต้องสำเร็จและความผิดที่รับไม่ได้เป็นชุดทดสอบ แล้วพัฒนา Agent พร้อมหลักฐานตรวจรับและวิธีดูแลหลังเปิดใช้
เริ่มพัฒนา Agent ที่ตรวจรับได้